Big Data – deel 2: Databases
In mijn vorige blog “Big Data – deel 1” heb ik beschreven hoe je kunt herkennen of uw organisatie te maken heeft met Big Data. In deze Blog neem ik u mee in de wondere wereld van databases, waarom nu veel van deze databases aan het veranderen zijn en wat deze veranderingen nu te maken hebben met Big Data.
De feiten (en dus data ) die verzameld / geregistreerd worden door de processen binnen uw organisatie dienen ergens opgeslagen te worden zodat deze bewerkt of verwijderd kunnen worden. Ongeacht de locatie (in huis: on-premises of uitbesteed: in de cloud), u heeft een gegevens bank nodig (database) waar deze data in wordt op geslagen. U kunt dan kiezen uit de hieronder genoemde databases (waarschijnlijk mis ik er nog een paar):
- Relationele databases
- Document Store
- Hadoop (Eco Systemen)
- Graph Databases
1. Relationele Database
Een relationele database is software die gemaakt is om feiten en beschrijvingen in tabellen te kunnen registreren, wijzigen en verwijderen zoals we kennen uit de statistiek. Het kenmerk relationeel uit zich in de relatie die de tabellen onderling hebben (3e NV). Een voorbeeld hiervan kun je zien in figuur 1.

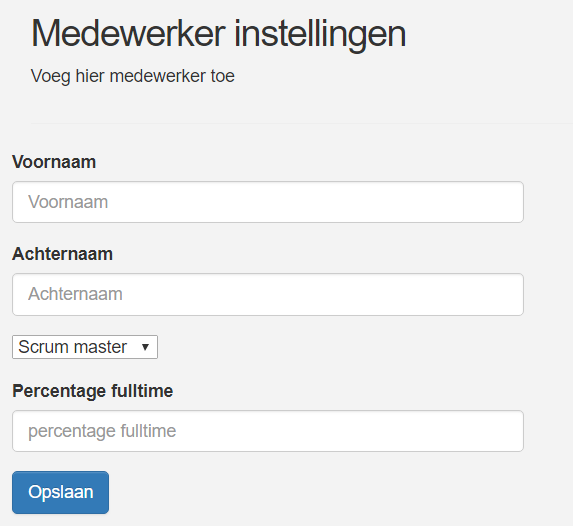
Feiten kunnen vast gelegd worden door schermen (IoT) of smart devices (Smart Phones, Tablets, Weerstations, Sensoren). Om van een simpel voorbeeld uit te gaan zie je in figuur 2 en 3 een voorbeeld van medewerker gegevens die worden opgeslagen in een database.

1.1 SQL
Om (business) context te creëren over deze data heen is binnen de relationele database wereld een uniforme taal ontwikkeld (ANSI) SQL (Structured Query Language), waarmee het mogelijk is om door middel van een vraag te stellen aan de database antwoord te krijgen in de vorm van een tabel.
In de basis geef je eerst aan (horizontaal) welke kolommen je nodig hebt (SELECT), daarna geef je aan van welke tabel (FROM). Als voorbeeld: Wanneer ik van de Employees tabel (zie afbeelding) alle voor- en achternamen wil hebben dan voer ik binnen SQL de volgende opdracht uit:”SELECT LNAME, FNAME FROM Employees”
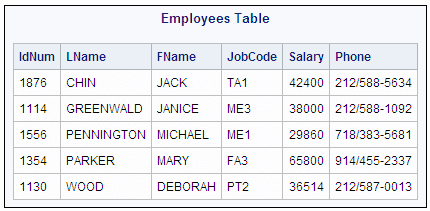
Belangrijke kenmerk van een RDBMS (Relationele Database Management System) is dat het zoeken naar data gebeurd via tabellen en kolommen.
2. Document Store
De Relationele Database is de oudste en de minst flexibele vorm om je data in op te slaan. Om de data van een scherm op te kunnen slaan in een Relationele Database is een onderliggende tabel vereist. Ook wanneer in het scherm een extra veld wordt toegevoegd dient in de database een extra kolom toegevoegd te worden. Bij een relationele database moet de data structuur dus van te voren bepaald worden.
In tegenstelling tot de Relationele Database is de relatie tussen de data structuren bij een Document Store opgeslagen in het document zelf. Het schema hoeft dus niet van te voren bekend te zijn. Hiermee ben je flexibel in je invoer, wat een groot voordeel heeft als je te maken heb met onbekende data van onbekende leveranciers.

We herkennen 2 type documenten die we kunnen opslaan in een Document Store
- XML (Tag based format )
- JSON (Curly brackets format)
Niet iedere database kan met allebei de bestandsformaten omgaan (Volgende blog gaat over tool selectie van Big Data Vendors) en in de regel maakt het niet uit welk formaat je kiest. Wel is belangrijk welke waarde je hieruit wilt hebben en hoe je deze data gevisualiseerd wilt hebben.
Het nadeel van een Document Store t.o.v. een Relationele Database is dat het uitvragen van de data meer tijd kost en minder gestandaardiseerd is (hierover meer in de blog van week 22 “SQL versus NoSQL).
3. Hadoop (Ecosystemen)
Hadoop is een verzamelbak van alle bestandsformaten die er mogelijk zijn. Het is vergelijkbaar met een folder op je computer waarin je alle bestandstypen kunt zetten die je maar wilt. Hadoop werkt met het HDFS (De Hadoop Distributed File System) waarin je lineair kan opschalen qua capaciteit en performance (scale out). Hadoop is ook Open Source wat inhoudt dat het gebruik van Hadoop geen geld kost in vorm van licenties.
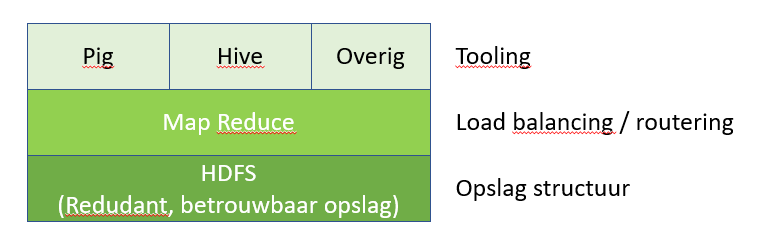
Om de data die opgeslagen is in Hadoop te ontsluiten dien je andere tools te installeren. Veel gebruikte tools zijn Hive, Pig, Sprak en MapReduce (hierover meer in de blog van week 22 “SQL versus NoSQL).
4. Graph Database
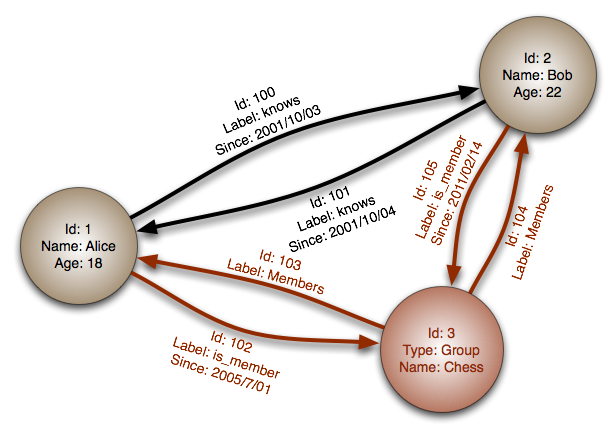
Een graven database maakt het mogelijk om op een simpele manier ingewikkelde hiërarchische en complexe structuren uit te vragen en op te slaan. Door middel van een graven structuur, zoals in figuur 6 is afgebeeld, wordt de data opgeslagen.
Conclusie
In de voorgaande hoofdstukken is beschreven welke database types er zijn en in welke vorm ze afwijken van elkaar. De belangrijkste vraag is “Wat wil ik met mijn data doen” of wel de context die je mee wilt geven. Het antwoord op deze vraag gaat je helpen een keuze te maken welke database het meest geschikt is voor je organisatie.