Big Data – deel 3: Marktaanbod
In mijn vorige blogs heb ik uitgelegd hoe je big data kunt herkennen en in welke type database je deze data kunt opslaan. In deze blog doe ik een poging om op een objectieve wijze richtlijnen te geven hoe je een database / tool selectie uitvoert en score ik de verschillende Big Data databases vanuit het ontwikkelaars perspectief.
1.Voorbereiding
Net als bij de aanschaf van een auto, houd je bij een tool/database selectie ook rekening met een aantal factoren. Dit zijn (af)wegingsfactoren. De wegingsfactoren waarin de partijen allemaal gelijk scoren heb ik uit de lijst gehaald, omdat deze waardes geen verschil gaan opleveren in het resultaat. Dit zijn onder andere: security, Active Directory Suport (LDAP) en Virtualisatie. Alle leveranciers voldoen hieraan, dus worden ze niet opgenomen in de lijst met wegingsfactoren.
Hieronder beschrijf ik de wegingsfactoren die je naar mijn mening mee zou moeten nemen bij het selecteren van een database en tooling:
1.2 Wegingsfactoren
1. Volledigheid
Met volledigheid wordt bedoeld: wat krijgt de organisatie na de installatie en kun je dan gelijk aan de slag?
De volgende aspecten neem ik hier in mee:
- volledige ontwikkelomgeving;
- monitoring van processen, inkomende en uitgaande data en responstijd;
- ondersteunen van meerdere query(vraag) talen en toepassingen.
2. Prijs
De score hiervoor is niet alleen gebaseerd op de kosten die je betaald aan de leverancier (licenties), maar ook indirecte kosten worden meegenomen in de weging (implementatie kosten en applicaties die nodig zijn om te kunnen werken).
3. Marktbekendheid
Met marktbekendheid wordt gekeken of de database voorkomt in de juiste kwadrant van Gartner, of er gemakkelijk expertise is in te huren en wat de leverancier doet om zijn product in de community te laten landen (gratis developer editie, forums etc.)
4. Integratie
Integratie is niet alleen het gemak waarmee verschillende applicaties aan elkaar gekoppeld kunnen worden, maar ook het aantal tools wat nodig is om je werk te kunnen doen.
5. Schaalbaarheid
Is het gemak waarmee je kunt op- en afschalen om de snelheid te kunnen beïnvloeden, de volgende factoren worden meegenomen in de weging:
- Support van Scale Out: hiermee wordt bedoeld het koppelen van verschillende apparaten i.p.v het zwaarder maken van 1 server. Deze techniek is vaak minder duur dan de server zwaarder maken.
- Support van Map Reduce: Als aanvulling van de Scale Out methode is de map reduce een techniek waarmee over een cluster van machines op een snelle wijze data verzameld en getoond kan worden.
6. Complexiteit
Hieronder wordt niet alleen verstaan de energie, tijd en geld wat geïnvesteerd moet worden om deze techniek onder de knie te krijgen, maar ook documentatie, cursussen en support van de leveranciers.
7. Performance
Hiermee wordt de responstijd voor het opslaan van de data en de responstijd voor het ophalen van de data bedoeld.
8. Flexibiliteit
Diversiteit van BI, Analytics en Data Science toepassingen die je kan uitvoeren na het installeren van de database.
9. Verschillende bestandstype
Dit is het kunnen absorberen van de verschillende bestandstypen (json, xml, csv, video, audio en foto’s) en deze te indexeren. Indexeren van de data is belangrijk om de bestanden te kunnen zoeken op basis van kenmerken.
Omgevingsfactoren
Daarnaast is het belangrijk om rekening te houden met de omgevingsfactoren welke spelen binnen de organisatie.
1. Kennis in de organisatie
De tooling en de database dient aan te sluiten op de kennis van de organisatie. Organisaties die veel techniek en kennis opbouwen in de organisatie kunnen overweg met een Big Data database die bestaat uit meer lagen (en dus meer configuratie).
2. Leer curve
De leer curve is de tijd dat de organisatie nodig heeft om de database en tooling eigen te maken. Dit is ook weer afhankelijk van de kennis en kunde van ontwikkelaars en beheerders (zie punt 1).
3. BI/Informatie Architectuur
Afhankelijk van de gekozen architectuur is de integratie van verschillende bronnen ook een must. In dit geval is het belangrijk dat de Big Data database kan communiceren met SQL databases en Message Queing (MQ service bussen) series.
4. Beheer
Het gemak en dus snelheid waarmee software / processen overgezet kan worden naar verschillende omgevingen (OTAP straat) en het beheren van verschillende versies.
1.3 Weging
Voor iedere wegingsfactor bepaal ik de maximale score. Dit doe ik omdat ik niet alle wegingsfactoren even belangrijk vind (hierover later meer) en daarom kunnen deze factoren niet allemaal een even hoge score halen.
Voor het scoren/wegen van de hierboven genoemde wegingsfactoren, gebruik ik een schaal verdeling tussen de 1 t/m maximale score, waarin 1 de slechtste score is en de maximale score het beste.
1.4 Verdeling Max. Score
| Max. Score | Criteria |
| 5 | Voldoet in bepaalde mate aan: Het product moet zich onderscheiden op tenminste de 3 V’s waarin Big Data voorkomt Of Het product is gebruiksklaar na installatie (geschikt voor Agile organisaties). |
| 4 | Voldoet in bepaalde mate aan: Komt voor in het Gartner kwadrant en capaciteit is makkelijk te verkrijgen. Of Kan alle BI, Analytics en Data Science toepassingen aan Of Kan data realtime opslaan, verwerken en bevragen. Of Voor het product wordt een gratis developer editie aangeboden en de prijs is marktconform |
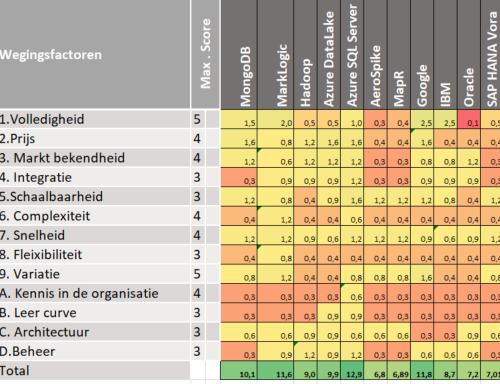
1.4 Score matrix
Wanneer deze score uitgezet is in een matrix krijg je het het resultaat dat in figuur 1 wordt getoond. In deze matrix heb ik alleen de score uitgezet op basis van technische (on)mogelijkheden. Het business gedeelte is per situatie en toepassing afhankelijk en dient in de tweede kolom ingevuld te worden.
2. Score van Leveranciers
Om de verschillende leveranciers te scoren op deze factoren gebruik ik de formule: score factor pakket = ((wegingsscore pakket * wegingsscore ) + (wegingsscore pakket * wegingsscore))/10. Deze formule zorgt ervoor dat de score nooit hoger kan zijn dan dat er aangeven is bij de maximale score.
2.1 Samenvatting van de scores
MongoDB en Key Value stores
Algemeen
MongoDB is een documentstore gebaseerd op json structuur (zie de blog Big Data voor Business deel 2). MongoDB heeft zijn eigen taal waarmee vragen gesteld worden aan de database. Het grote voordeel van MongoDB is dat het een grote community heeft en aansluit op de meeste gebruikte ontwikkeltalen. Echter wanneer je het breder wil inzetten, dien je een aantal vertaal slagen te maken om waarde uit je data te kunnen halen.
MongoDB heeft ook een community editie welke gratis is om te installeren. Ook de installatie zelf is redelijk simpel.
Volledigheid en integratie
Na de installatie krijg je echter alleen de database en geen ontwikkelomgeving meegeleverd. Verder is mijn ervaring dat het slecht te integreren is met andere applicaties zonder interventie van andere tools.
Prijs
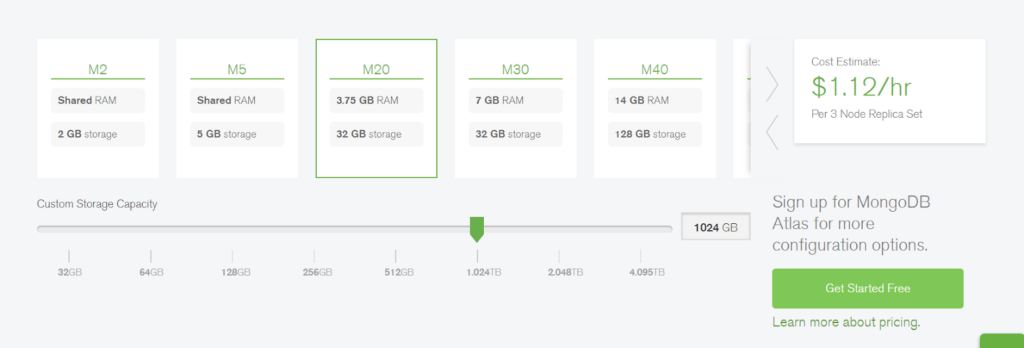
De prijs van MongoDB is voor 1 TB 10.000 euro per jaar aan de dure kant voor een redelijk simpele opgezette database.
Vergelijkbare producten
Vergelijkbare systemen zijn Key Value stores i.p.v. documentstore (object). Dit zijn databases die de data opslaan op basis van een sleutel en een waarde (key and value). Voordeel van deze structuur is dat je geen verloren opslag hebt en dat alle data in een grote tabel wordt opgeslagen.Het nadeel hiervan is dat hier net als een relationele database geen foto’s, audio of video bestanden opgeslagen kan worden. Hier dien je dan Hadoop of een andere BLOB (Binary Large Object) store voor gebruiken.
MarkLogic
Algemeen
MarkLogic is een echte allround Big Data database systeem, kan meerdere bestandstypen aan en kan bevraagd worden met verschillende query talen (SQL, SparQL, Semantic Query, Javascript, XQuery en nog veel meer). MarkLogic kan zowel lokaal als in de cloud geïnstalleerd worden. De installatie is net als MongoDB erg makkelijk om uit te voeren.
Volledigheid en Integratie
Na de installatie krijg je een complete web georiënteerde ontwikkelomgeving. Het voordeel van deze omgeving is dat je hier niets voor hoeft te installeren op de cliënt omgevingen en is daarom erg geschikt voor thin clients (Citrix omgevingen). Daarnaast heeft MarkLogic veel moeite gedaan om integratie mogelijk te maken met relationeel georiënteerde systemen (ODBC drivers), rapportage tools (Power BI, Tableau en Cognos) en Hadoop.
Prijs
De prijs per node is 18.000 euro per jaar per machine, daarnaast hebben ze een developer editie welke gratis is in gebruik.
Hadoop EcoSystemen
Algemeen
MongoDB en MarkLogic zijn gebaseerd op een standalone architectuur. Hiermee wil ik zeggen dat er geen andere applicaties nodig zijn om te kunnen beginnen. Zoals ik in “Big Data voor Business deel 2” heb beschreven dien je voor Hadoop een aantal applicatie erbij te installeren om aan de slag te kunnen. Persoonlijk vindt ik dit een nadeel omdat er kennis nodig is van de losse applicaties en hoe deze geconfigureerd moeten worden zodat ze met Hadoop kunnen praten en zinvolle informatie kunnen weergeven.
Het Hadoop Ecosysteem ontzorgt de ontwikkelaars dat zij zich niet bezig hoeven te houden met de configuratie en installatie van deze systemen. Deze Ecosystemen zijn alleen te verkrijgen in de cloud en voor iedere losse applicatie dien je te betalen.
De volgende (Cloud)producten maken gebruik van de Hadoop architectuur:
- SAP Vera;
- Azure Data Lake;
- Oracle Big Data;
- Cloudera;
Volledigheid en Integratie
Het aan de praat krijgen van het Hadoop Eco Systeem is redelijk simpel wanneer je ervaring hebt met cloud diensten. Daarnaast kunnen de applicaties ook met andere apps en services praten die je bij dezelfde cloud provider hebt aangeschaft.
Prijs
Om datastreams (bronnen van internet) aan te sluiten op deze Cloud Providers dien je weer andere apps af te nemen, ook voor bepaalde toepassingen (eleastic search, geo search) dien je te betalen. Hierdoor zijn er onderwater veel bijkomende kosten. De cloud leveranciers creëren op deze manier een afhankelijkheid zodat organisaties gedwongen zijn om overige diensten en producten van hun af te nemen (cross selling en up selling).
Google Cloud versus Azure Cloud
Algemeen
Ik ben van mening dat Google de meest betaalbare en flexibele cloud provider is die er is. Bijna alle toepassingen die je maar kan bedenken kan je aanschaffen bij Google. Ook het ondersteunen van hybride architectuur (deels cloud en deels in huis) is mogelijk bij Google. Om deze diensten te kunnen gebruiken dien je wel redelijk wat ervaring te hebben met het ontwikkelen van (REST) API en het gebruik.

Azure is daarentegen wat gebruiksvriendelijker maar kent minder toepassingen dan Google. Ook is Azure in verhouding duurder dan de Google Cloud.
Volledigheid en Integratie
Qua volledigheid wint Azure het van Google. Voor Google moet je veel meer configureren dan binnen Azure. Plus dat er meer kennis is op het gebied van Microsoft dan op gebied van Google API’s.
Prijs
Om datastream(bronnen van internet) aan te sluiten op deze Cloud Providers dien je weer andere apps af te nemen, ook voor bepaalde toepassingen (eleastic search, geo search) dien je te betalen. Hierdoor zijn er onderwater veel bijkomende kosten.Microsoft creërt op deze manier een afhankelijkheid zodat organisaties gedwongen zijn om overige diensten en producten van hun af te nemen (cross selling en up selling).
3. Conclusie vanuit architectuur perspectief
Mijn advies is afhankelijk van het doel waarvoor je de database wilt gebruiken. Ik zie hier twee sporen ontstaan:
- Data Lake;
- Verticals (Specifieke toepassingen).
3.1 Datalake
Een Data Lake heeft als doel om zoveel mogelijk data op te slaan zonder hier context aan mee te geven. Bij een Data Lake is het belangrijk om alle vormen van data op te kunnen slaan en te indexeren. Hier komen twee systemen voor in aanmerking dat zijn de Hadoop Ecosystemen en MarkLogic. Wanneer ik deze beoordeel op volledigheid krijg ik na de installatie meer vanuit MarkLogic dan vanuit Hadoop. En zal ik op basis van die reden ook altijd MarkLogic adviseren.
3.2 Verticals (Specifieke toepassingen)
Wat betreft de Verticals is het belangrijk om zo dicht mogelijk tegen de taal aan te zitten waarin je ook in gaat programmeren. Alle tussen stappen die je moet doen om te vertalen (bijvoorbeeld van xml naar json) werken vertragend. Zoek hierbij dus naar een database die je hierin zo goed mogelijk in ondersteund:
Ontwikkeltalen:
- Javascript en Nodejs: MongoDB;
- Data Science en Machine Learning: MarkLogic;
- Java: MongoDB.